핵심 요약
- 조사지별 평균표를 받을 때는 평균에 쓴 값의 개수도 같이 받습니다.
- 잘못 적힌 값 하나가 조사지 평균의 순서까지 바꿀 수 있습니다.
- 상관관계가 강하게 나와도 원인이라는 뜻은 아닙니다. 조사지로 나눠 다시 봅니다.
오늘의 질문조사지마다 평균이 다른지, 고도가 높을수록 흙이 마르는지 AI에게 어떻게 물어볼까?
조사지끼리 평균을 비교하고 두 변수의 상관관계를 보는 일은 AI에게 표 하나로 부탁할 수 있습니다. 상관관계는 한 변수가 커질 때 다른 변수도 함께 커지거나 작아지는 관계를 말합니다.
이 글에서도 이 연재에서 계속 쓰는 가상의 조사 데이터(조사지 3곳 × 방형구 20곳)를 씁니다. 결과 상자의 숫자는 이 데이터로 실제 계산한 값입니다. 2편에서 찾은 토양 pH 58.3(방형구 C08)은 아직 고치지 않은 상태입니다.
연재AI와 함께하는 연구 데이터 분석
- 시작 전에: 연구자의 AI 작업실 만들기 설치·준비 4편
- 1편. AI 데이터 분석, 무엇을 맡길까
- 2편. 데이터 탐색, AI에게 먼저 물을 것
- 3편. 그룹별 비교와 상관관계 묻기 지금 읽는 글
- 4편. ChatGPT로 CSV 그래프 그리기
- 5편. 결측치 처리: 지울까, 채울까
- 6편. 분석 전 데이터 정리 맡기기 준비 중
- 7편. 이상한 값과 입력 실수 찾기 준비 중
- 8편. 숫자 예측 모델, AI로 돌리기 준비 중
평균표와 상관계수가 알려 주는 것
조사지별 평균표는 조사지마다 대표값을 하나씩 뽑아 나란히 세운 표입니다. 반별 시험 평균을 비교하는 것과 같습니다. 평균 하나에는 몇 개 값으로 냈는지가 드러나지 않아서, 개수를 함께 받아야 합니다.
상관계수는 두 숫자 변수가 한 직선을 따라 함께 움직이는 정도를 -1에서 1 사이 값 하나로 나타냅니다. 양수면 한쪽이 커질 때 다른 쪽도 커지고, 음수면 다른 쪽이 작아집니다. 1이나 -1에 가까울수록 점들이 직선에 가깝고, 0이면 직선 관계가 없다는 뜻입니다(SciPy 문서, 호주 통계청).
AI에게 그룹별 비교와 상관관계 묻기 3단계
1. 조사지별 평균표 묻기
이렇게 요청합니다
quadrat_survey.csv 파일에서 조사지(A, B, C)별로 고도, 토양 pH, 토양 수분의 평균을 표 하나로 정리해 줘.
조사지마다 방형구가 몇 곳인지 첫 열에 적고, 소수점은 한 자리까지 보여 줘.
이렇게 나옵니다
| 조사지 | 방형구 수 | 고도 (m) | 토양 pH | 토양 수분 (%) |
|---|---|---|---|---|
| A | 20 | 127.8 | 5.3 | 41.1 |
| B | 20 | 470.8 | 6.0 | 31.8 |
| C | 20 | 869.2 | 8.0 | 24.9 |
고도는 A에서 C로 갈수록 높아지고, 토양 수분 평균은 41.1%에서 24.9%로 낮아집니다. 그런데 토양 pH는 C만 8.0으로 혼자 높습니다.
생각해 볼 점
- C의 pH 평균 8.0은 2편에서 찾은 58.3 한 값이 끌어올렸을 수 있습니다. 다음 단계에서 확인합니다.
- 방형구는 20곳씩이지만, 빈칸이 있는 열은 평균에 들어간 값이 더 적습니다. 평균표에는 개수를 같이 적어 달라고 합니다.
2. 튀는 값을 빼고 다시 묻기
이렇게 요청합니다
토양 pH 58.3(C08)은 5.83을 잘못 적은 값으로 보여. 원본 파일은 고치지 말고,
이 값만 뺀 조사지별 토양 pH 평균을 원래 평균 옆에 나란히 표로 보여 줘. 평균에 쓴 값의 개수도 적어 줘.
이렇게 나옵니다
| 조사지 | 원래 평균 | 58.3 뺀 평균 | 평균에 쓴 값 수 |
|---|---|---|---|
| A | 5.3 | 5.3 | 19 |
| B | 6.0 | 6.0 | 19 |
| C | 8.0 | 5.0 | 17 |
A와 B는 그대로이고, C만 8.0에서 5.0으로 내려갑니다. 가장 높아 보이던 C가 세 조사지 중 가장 낮은 쪽이 됐습니다.
생각해 볼 점
- 값 하나가 조사지 순서를 뒤집었습니다. 그룹끼리 평균을 비교하기 전에 튀는 값부터 확인해야 합니다.
- C는 빈칸 2칸과 뺀 값 1개 때문에 17개 값으로 평균을 냈습니다. 5.83으로 고칠지는 원자료(야장)를 보고 사람이 정합니다.
3. 두 변수의 상관관계 묻기
이렇게 요청합니다
고도와 토양 수분이 함께 움직이는지 알고 싶어.
세 조사지를 합친 상관계수와 조사지별 상관계수를 표로 비교하고, 각각 방형구 몇 곳으로 계산했는지 적어 줘.
조사지별로 색을 나눈 산점도도 그려 줘.
이렇게 나옵니다
| 범위 | 고도 범위 (m) | 방형구 수 | 상관계수 |
|---|---|---|---|
| 세 조사지 합침 | 57–932 | 58 | -0.82 |
| 조사지 A | 57–213 | 19 | -0.21 |
| 조사지 B | 407–509 | 19 | -0.09 |
| 조사지 C | 794–932 | 20 | -0.41 |
이렇게 나옵니다
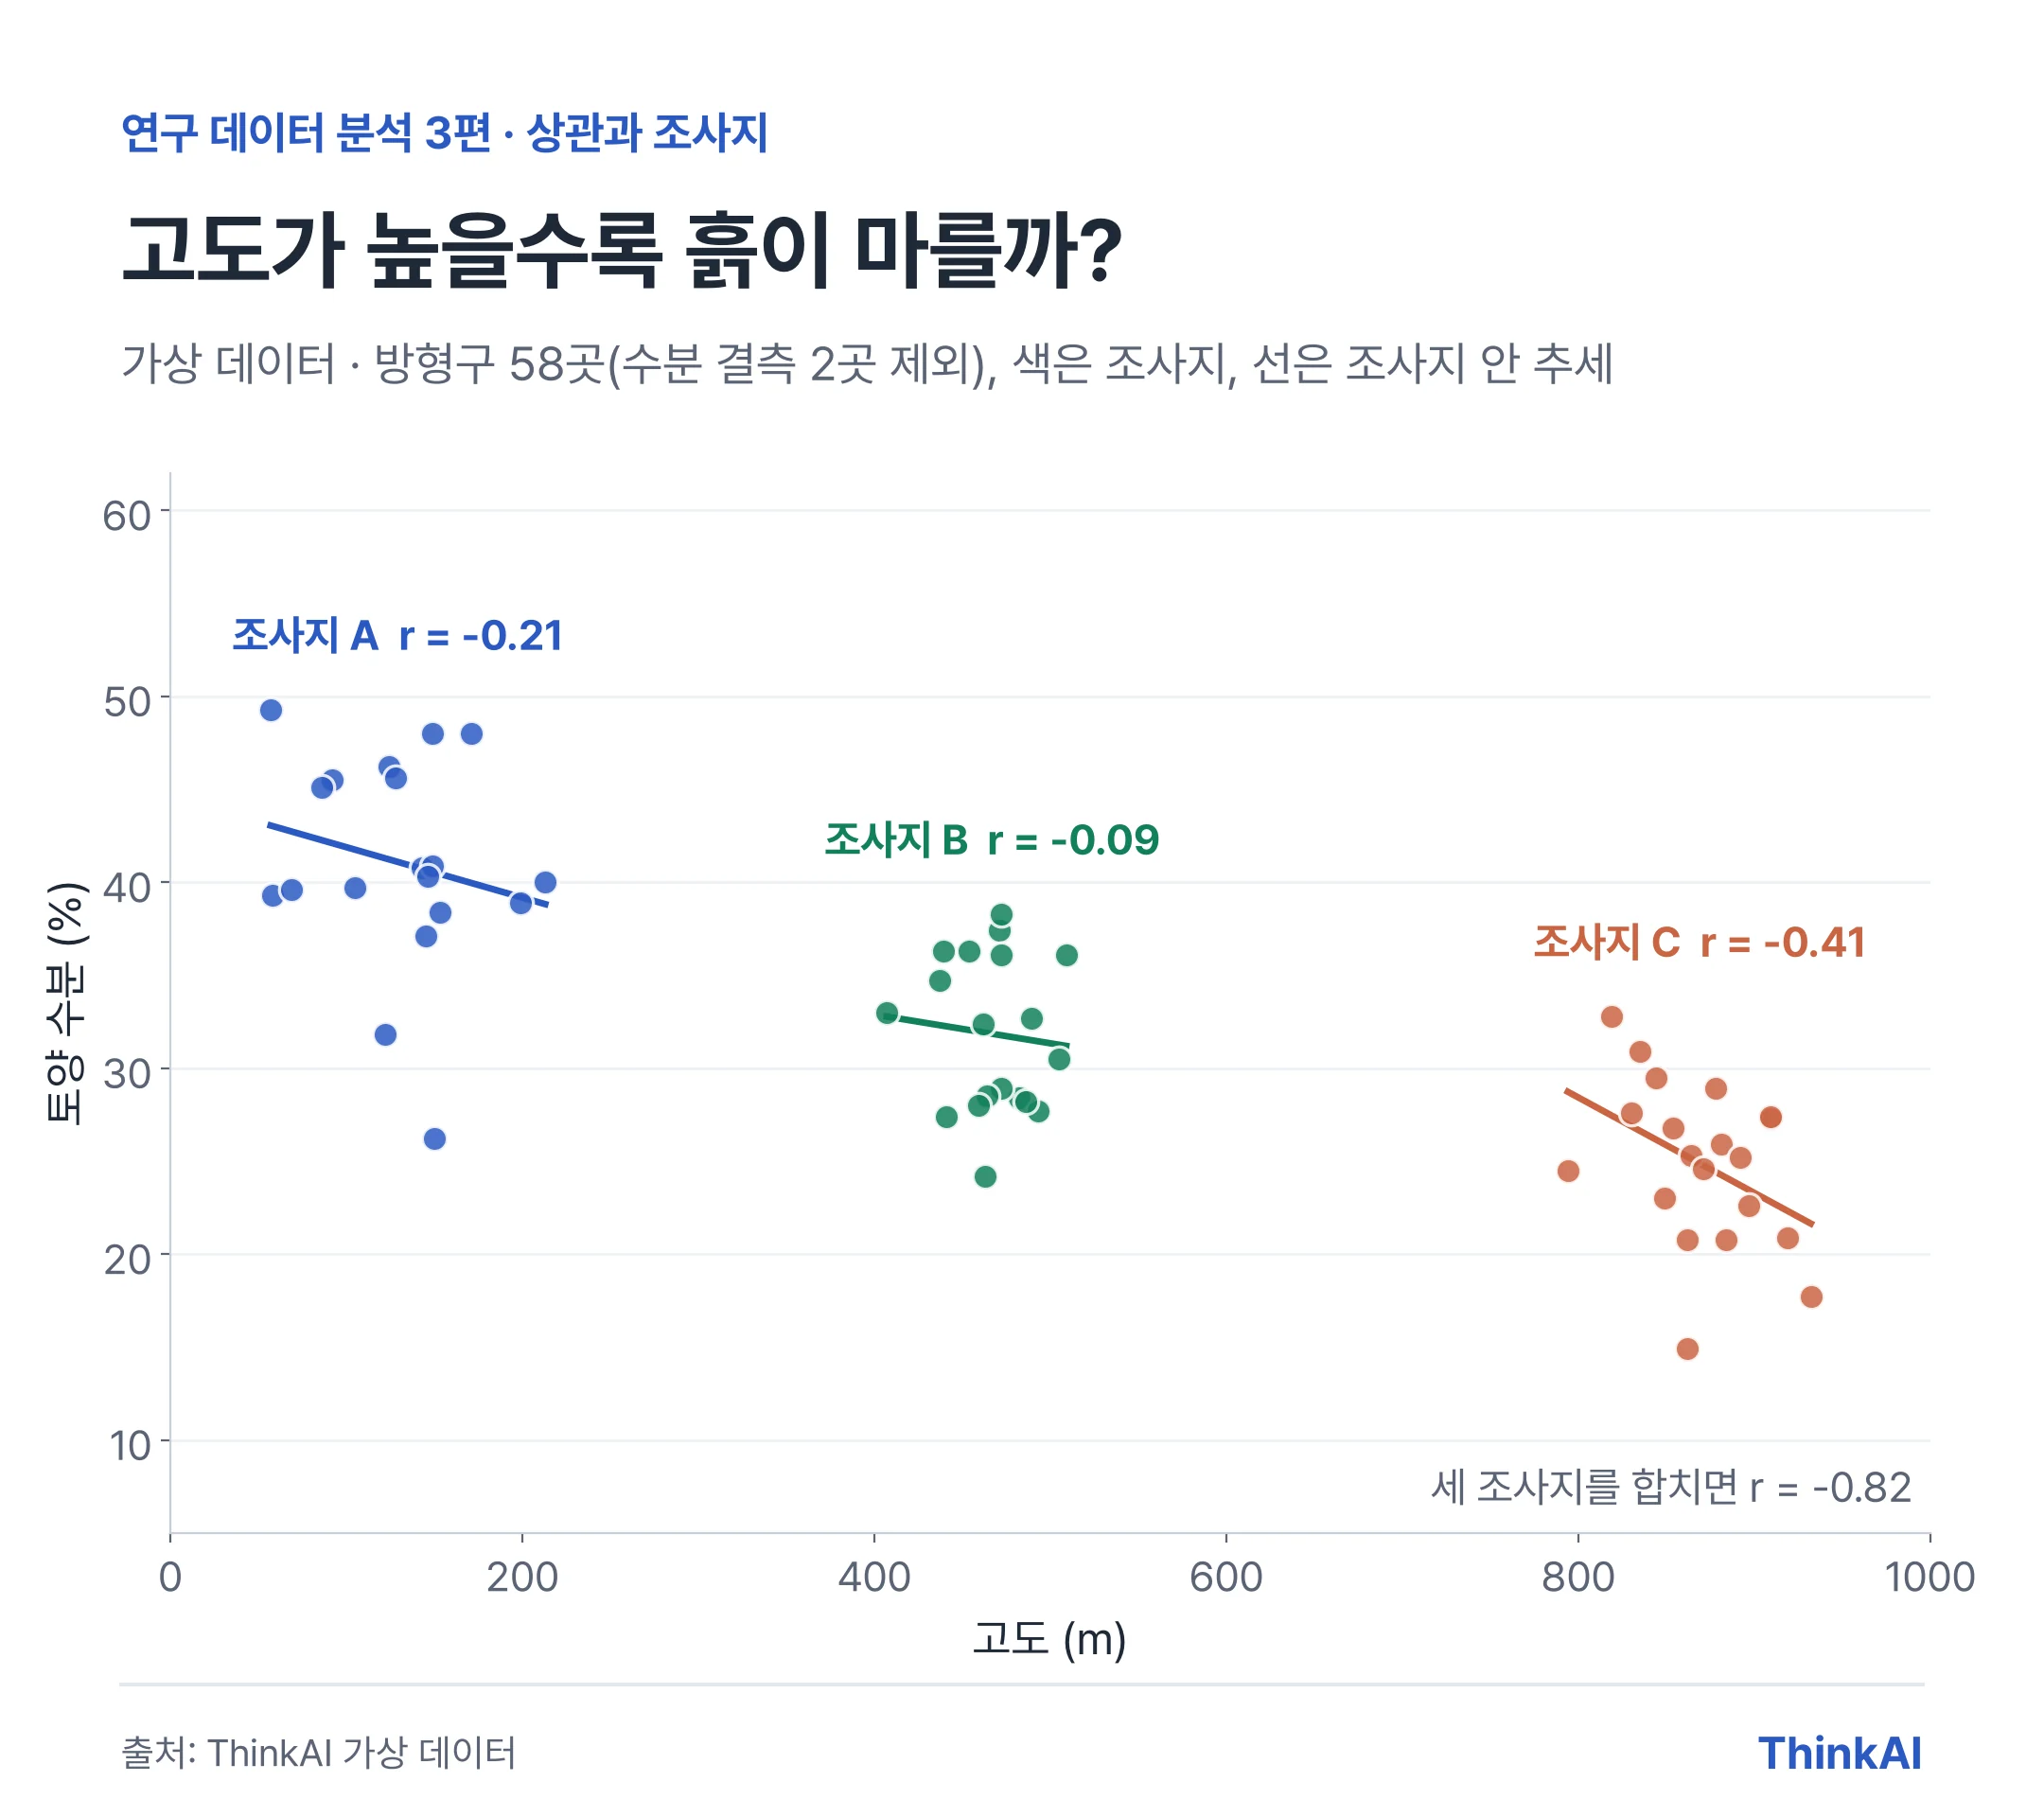
세 조사지를 합치면 상관계수가 -1에 가까운 -0.82입니다. 그런데 조사지 안에서만 보면 -0.09에서 -0.41 사이로 훨씬 약합니다. 산점도에서도 점들이 조사지별로 세 덩어리로 떨어져 있습니다.
생각해 볼 점
- 상관관계는 원인을 알려 주지 않습니다. 이 데이터에서 고도가 다르다는 것은 곧 조사지가 다르다는 뜻이라, 조사지 사이의 다른 차이(토양, 관리 이력 등)가 함께 섞여 있을 수 있습니다.
- 조사지 안 계수는 19–20곳으로 계산한 값입니다. 이 표만으로 “고도가 수분을 낮춘다”고도, “관계가 없다”고도 쓰지 않습니다.
이럴 때 이렇게 되묻습니다
AI 답의 표현은 매번 달라도 숫자는 위 결과 상자와 같아야 합니다. 숫자가 다르거나 해석이 앞서 나가면 아래처럼 되묻습니다.
| 이런 답이 나오면 | 이렇게 다시 묻기 |
|---|---|
| 평균표에 개수가 없음 | “평균마다 몇 개 값으로 계산했는지 옆 열에 적어 줘” |
| 한 조사지 평균만 유독 튐 | “그 조사지에서 가장 큰 값과 작은 값을 세 개씩 보여 줘” |
| 전체 상관계수만 알려 줌 | “조사지별로 나눠서도 계산해 줘” |
| “고도가 수분을 낮춘다”고 설명함 | “이 결과만으로 말할 수 있는 것과 없는 것을 나눠 줘” |
정리
그룹별 비교는 평균과 개수를 한 표로 받는 것에서 시작합니다. 이 데이터에서는 토양 pH 58.3 하나가 조사지 C의 평균을 8.0으로 끌어올려 순서를 뒤집었습니다. 고도와 토양 수분의 상관관계는 합쳐 보면 -0.82였지만, 조사지 안에서는 훨씬 약했습니다. 상관계수를 받으면 그룹으로 나눠 다시 묻는 것까지 한 세트로 기억해 두면 됩니다.
다음 편 예고ChatGPT로 CSV 그래프 그리기: 어떤 그래프가 맞는지 AI에게 추천받고, 조사지별 상자그림 하나를 골라 요청하는 법을 다룹니다.
출처
- SciPy 1.18.0 문서, “scipy.stats.pearsonr” (2026-09-29 확인)
- Lumen Learning, Concepts in Statistics “Causation and Lurking Variables (1 of 2)” (2026-09-29 확인)
- 호주 통계청(ABS), “Correlation and causation” (2023-02-02)